云开体育现时看到更多的是学习-开云官网登录网址官方网站入口(中国)
K3.1 Pro发布后不到48小时,月之暗面就放出公告称“模子存在的限速、额度无故虚耗问题,咱们深表歉意。这些问题全是咱们的累赘,本该更早股东措置。10月26日起,通盘档位订阅用户返还月度总数的25%。咱们还诊治了居品运行参数,砍掉不必要的子Agent调用、压缩冗余输出长度,让额度更耐用。”
在此次改换后,最显明的体验即是,K3.1 Pro莫得刚发布那会“烧额度”了。
回到模子发布本日,通盘这个词AI圈子都倒吸一口寒气,性能超越OpenAI通盘模子,仅逾期Opus 5.5半个脚掌。第三方评测机构ModelCompare发文称,中好意思AI差距已从3、4个月缩减为仅剩31天。
关联词这场狂欢还没撑过两天,K3.1 Pro的评价就从“稀零好评”,酿成了“多半好评”。杨植麟也被冠上了“神鬼二相性”的混名,神在于模子性能冲突天空,鬼在于K3.1 Pro用起来些许有点“肉疼”。
反映最多的即是额度问题。社区多位用户称,险些没若何用,就一经花光了K3.1 Pro的5小时额度。就拿我我方来说,199块钱的档位,两天一共生成不到10个3D模子和几个时长不高出30秒的演示动画,月额度一经跑罢了一半。
哪怕是一些简短的任务,K3.1 Pro也会调用多数的子Agent来想考、推理,其输出扫尾并莫得进步很大,却因为这些子Agent,导致用户糜掷了好多额度。
杨植麟也挺无奈,进步模子的智能水平势必需要更多的token。
这也就导致K3.1 Pro诚然比K3低廉了30%,却因为额度给得太少,导致终末并莫得些许东说念主信得过感受到了“低廉”。
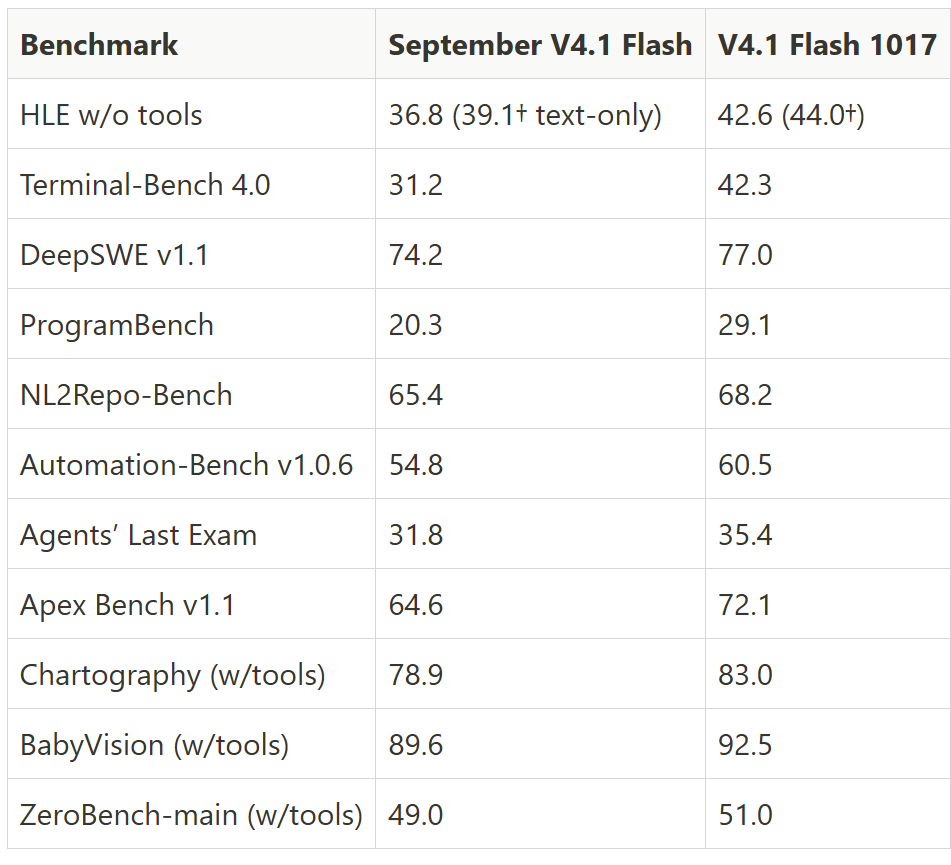
就在K3.1 Pro发布的前一周,DeepSeek发布了V4.1 Flash-1017,它的想路统统相悖:不拼上限,而是把性能、速率、输出长度一王人优化,价钱保持不变。
V4.1 Flash-1017完竣体现了梁文锋的居品形而上学,自愿布于今仍然是“好评如潮”。
或然杨植麟就该在居品上,该跟梁文锋取取经。
额度是月之暗面最大的伤
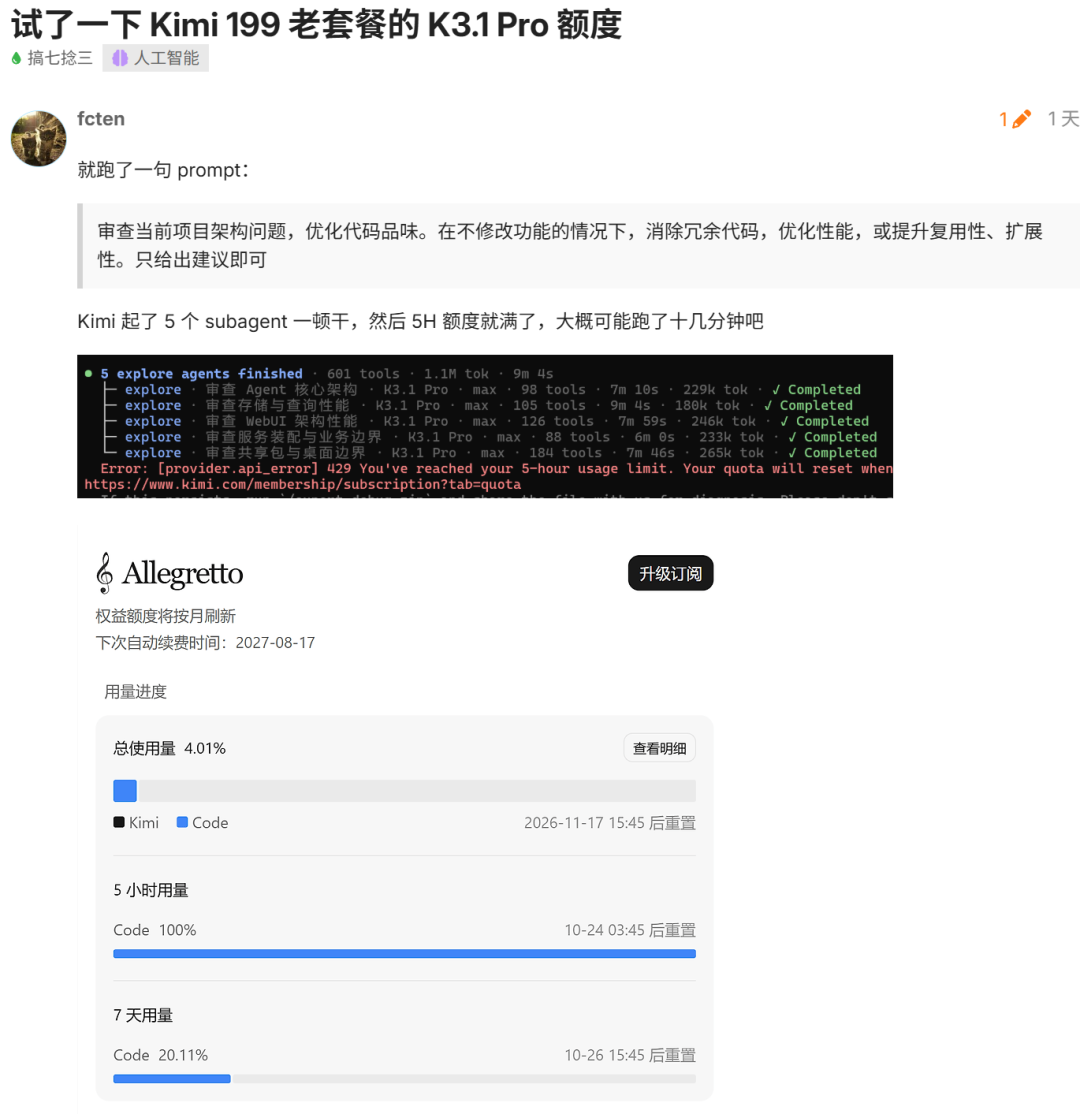
K3.1 Pro发布后,社区里有好多东说念主都在商榷额度的问题。比如有这么一条高赞驳倒,发帖东说念主称“它粗略只用了10分钟,5小时的额度窗口就一经满了”。
Linux.do上,有一位199套餐用户,他暗意只发了一句让模子审查式样架构的指示,Kimi拉起5个子 Agent,十几分钟后5小时额度就满了。
微博用户@这很盒里吧发帖暗意,在WorkBuddy里使用K3.1 Pro,一个简短任务还没跑完,就花掉了高出450的积分。
而实践上,WorkBuddy的99块钱圭臬版,一个月所有也就4000积分。额外于一个简短任务,跑了月额度的10分之1。@这很盒里吧还暗意,K3.1 Pro现时消耗积分的倍率是0.97,也即是说,实践上积分消耗要更少一些。
Artificial Analysis认为,之是以K3.1 Pro如斯消耗额度,关节就在于token效用上。
在测试中发现,K3.1 Pro跑完整套Intelligence Index测试集,一共要输出约1.5亿个token,同价位模子的中位数是8700万。
归拢套测试,GPT-6.1 Sol只用了约6700万,GPT-6 Astra约6000万。按OrcaRouter的换算,相似的任务K3.1 Pro的输出量梗概是Astra的2.5倍。
Artificial Analysis还暗意,K3.1 Pro的速率也低于同类的中位数,梗概每秒70多到80个token。另外,K3.1 Pro只相沿想考花样,关闭想考的申请会被告成拒却,每一次调用都在为推理付费。
诚然K3.1 Pro推出了高速(Highspeed)版块,但是月之暗面官方暗意,高速版只加速模子输出。任务里器具调用(读写文献、履行号召等)与剧本履行的耗时不受影响,淌若这部分占比大,举座提速就不显明。
诚然K3.1 Pro相较于K3低廉了30%,可Artificial Analysis在测试中发现,K3.1 Pro的单次任务本钱并莫得低廉到那儿去。
K3.1 Pro平均单次任务的耗尽为2.11好意思元,GPT-6 Astra为3.26好意思元。而K3.1 Pro的token价钱唯一Astra的五分之一,可落到实践耗尽上,只省了梗概35%。
这一切可能和K3.1 Pro的磨砺筹商。
杨植麟认为,要想让模子已毕更长的输出,那就必须得在通盘这个词过程中恒久保持严谨,反复查验、修改、自我修正。从K3运转即是如斯,其时的官方本领文档里写到,K3会在输出中施展出过度严慎、反复自我凝视。
Fireworks AI官方考虑博客《Introducing Ember-1》中提到,就算拿掉了K3反复查验的过程,对模子性能险些莫得影响。换句话说,K3有点太严谨了。
到了K3.1 Pro,模子不仅要对任务严谨,还对通盘这个词环境严谨。
K3.1 Pro官方本领讲解里提到过一个案例,模子模拟东说念主学习行走的过程,K3.1 Pro发现手臂行为恒久不睬想、诊治奖励也莫得措置,于是回头查验模拟器,修掉了36处肩部肌肉力臂的探究不实,再再行磨砺,最终才让效果更好。
这亦然为什么K3.1 Pro诚然性能很高,关联词输出更长,token更多,因为它要对险些一切保持严谨,以致连环境都是如斯。
杨植麟烧token,梁文锋则是省token。
DeepSeek称V4.1 Flash 1017的迭代为“帕累托校正”。这是一个经济学见地,它指的是一件事改完之后,至少有一个方面变好了,同期莫得任何一个方面变差。
放在模子里体现出的,即是模子的各项基准分数更高,任务完成更快,输出更短,价钱也莫得变。
DEV社区里就有东说念主作念过测试,说DeepSeek V4.1 Flash 1017比拟较4.1 Flash,输出变短、任务变快,每完成一个任务的本钱,反而下跌了。
其实V4.1 Flash自己是个极其“话痨”的模子,OrcaRouter上就有实测暗意,相似是在Artificial Analysis那套Intelligence Index上,V4.1 Flash要输出2.5亿token,比K3的1.6亿还多56%。
但是由于V4.1 Flash的Causal Encoder-Decoder架构,552B总参数但prefill只激活8B、decode只激活16B。KV缓存被压到每token唯一890字节,显存占用降到上代的四分之一、SSD占用上代的八分之一。
是以DeepSeek跑分更强、任务完成更快、输出还变短,梁文锋不肯意点火掉某一项属性换来另一项。
Agent是做事AGI的一环
梁文锋也曾说过,“现时投资东说念主看到的最多的是Agent,但关于咱们这些考虑的⼈来讲,现时看到更多的是学习,以及若何措置学习这个问题。”
话里有话,梁文锋以为Agent仅仅AGI的一环而非全部。
2025年的时辰,杨植麟登上了张小珺《交易访谈录》。关于纯推理模子和Agent,杨植麟建议了一个缸中之脑表面:“瞎想一个鱼缸,你把一个脑子放在内部,跟外界莫得筹商。它仅仅在我方大脑内部想,一直想,不需要跟外界产生任何交互,就能解一说念题。”
关于Agent,杨植麟说:“它不再是‘缸中之脑’,是跟外界有交互的。我的下一走路为,是字据交互中获得的反映,和外界给我的新景况的更新筹商系。”
缸中之脑就代表了o1那样的强推理模子,可杨植麟想要的,是让模子能够使用更多的器具,进行更多轮的交互。
不外无论梁文锋和杨植麟若何说,那都是他们在居品形而上学方面临Agent的界说,真要看模子Agent如何,还得放到着实任务里。
除了Artificial Analysis,社区也经常用“致知|大模子才略耐久跟踪榜单”(猫榜)来测试模子的水平。
它把模子的才智拆成推理、Agentic和视觉三个板块。在Agentic这一页,用的是一组需要长历程、多握住和器具配合的任务。左边的数字和字母,暗意扣分数和档位,页面上写着“1/A 代表扣分数/档位”,数字越小越好;右边的¥金额,看起来是模子跑完这说念题的耗尽。
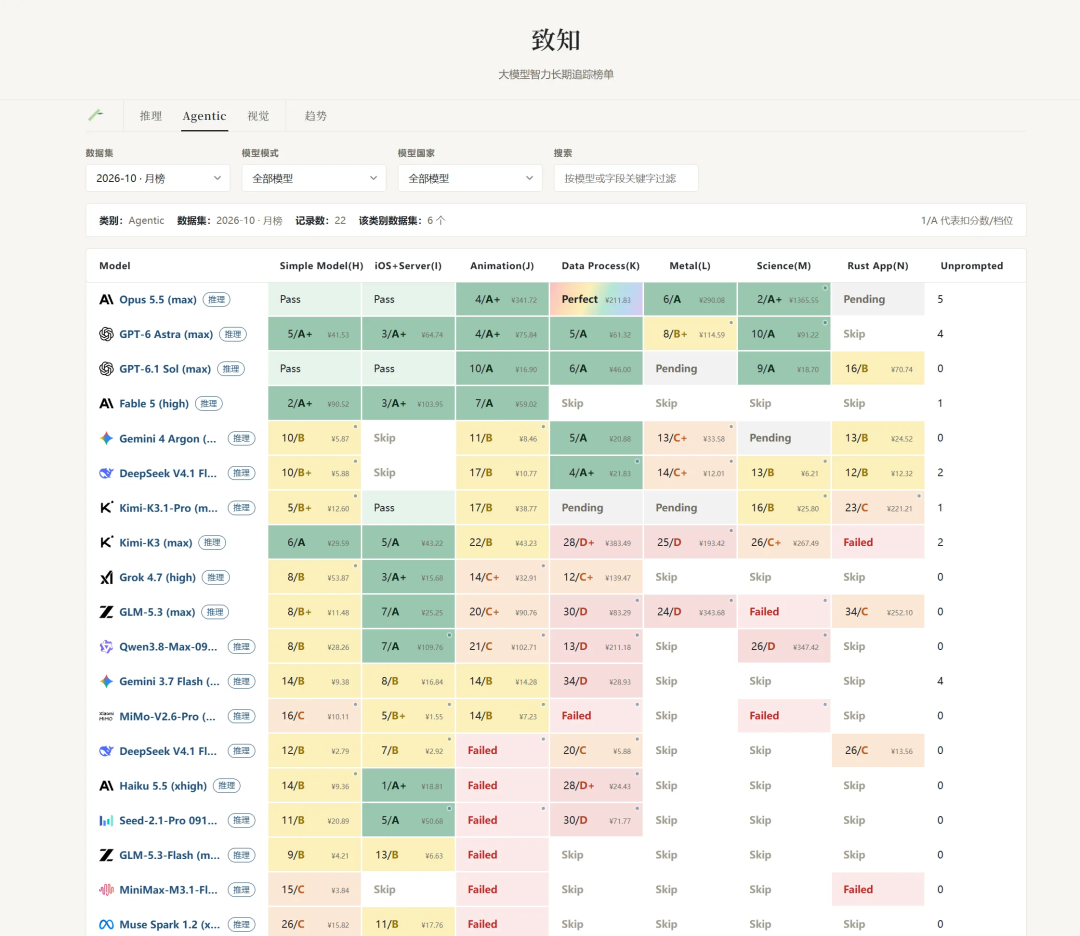
比拟上一代K3,K3.1 Pro的越过相当显明。K3在Rust App上是“Failed”,也即是不成已毕,K3.1 Pro则拿到了23分、C档;K3在Science上是26分、C+,K3.1 Pro进步到了16分、B档;Animation也从22分提到了17分。
这个扫尾,和月之暗面官方强调的“Agent履行才智大幅进步”是吻合的。
关联词在这个榜单上,K3.1 Pro却输给了DeepSeek V4.1 Flash 1017。
Rust App上,DeepSeek V4.1是12分、B档;K3.1 Pro是23分、C档;Simple Model这一项,K3.1 Pro是5分,DeepSeek是10分,两者同为B+档,Kimi略好一些;Animation这一项,两边都是17分、B档,打平;Science 一项,DeepSeek是13分,Kimi 是16分,同为B档,DeepSeek略好。
另外,K3.1 Pro在Data Process和Metal两项如故“Pending”,意味着完整的论断现时还不成下。
明明在Artificial Analysis上直逼Opus 5.5的K3.1 Pro,却在这里评分低于DeepSeek?
这是由于猫榜有个端正,“模子不截止Max Token,但字据题目难度对超长想考进行扣分刑事累赘。”等于你花的token越多,就越给你扣分,K3.1 Pro吃了大亏。
在Rust App上,DeepSeek花了12.32元,K3.1 Pro花了221.21元。Simple Model上,Kimi花了12.60元,DeepSeek是5.88元。Animation上,Kimi是38.77元,DeepSeek是10.77元。Science上,Kimi是25.80元,DeepSeek是6.21元。
还有少量,K3.1 Pro的本领博客里写到,模子会“过度主动(excessive proactiveness)”,遭遇朦胧意图会替你作念决定、过度随心。尤其是关于Agent来说,K3.1 Pro更兴隆去字据提醒词来开脱施展。
可猫榜内部,像是Rust App这类任务,它的环境反映链极长、需求限度统统卡死,会严格截止模子的施展。
梁文锋在作念的,是让每一次Agent调用都安定、低廉;杨植麟在作念的,是让最难的那几个场景,看起来鼓胀惊艳。
月之暗面需要“克制”
K3.1 Pro的3D才智是发布的重心之一。你不错给模子几张图片,不需要叮属任何事情,它就能将其调遣成3D建模。
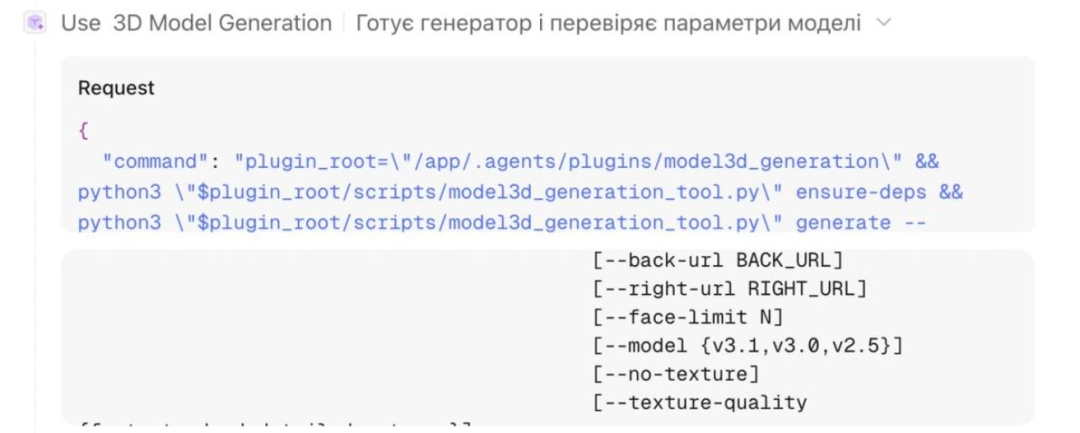
发布后的第二天,社区上出现了一个高赞帖子。发帖东说念主称,他发现Kimi内置了一个名为model3d_generation的手段,会运行一段Python剧本,通过外部API的做事来生成3D模子。
发帖东说念主成心禁用了这个手段,让K3.1 Pro只用我方的代码生成,质料显明差了一截。更关节的是,剧本里相沿三个模子版块:v3.1、v3.0和v2.5,这和3D生成公司Tripo AI的模子版块统统吻合。
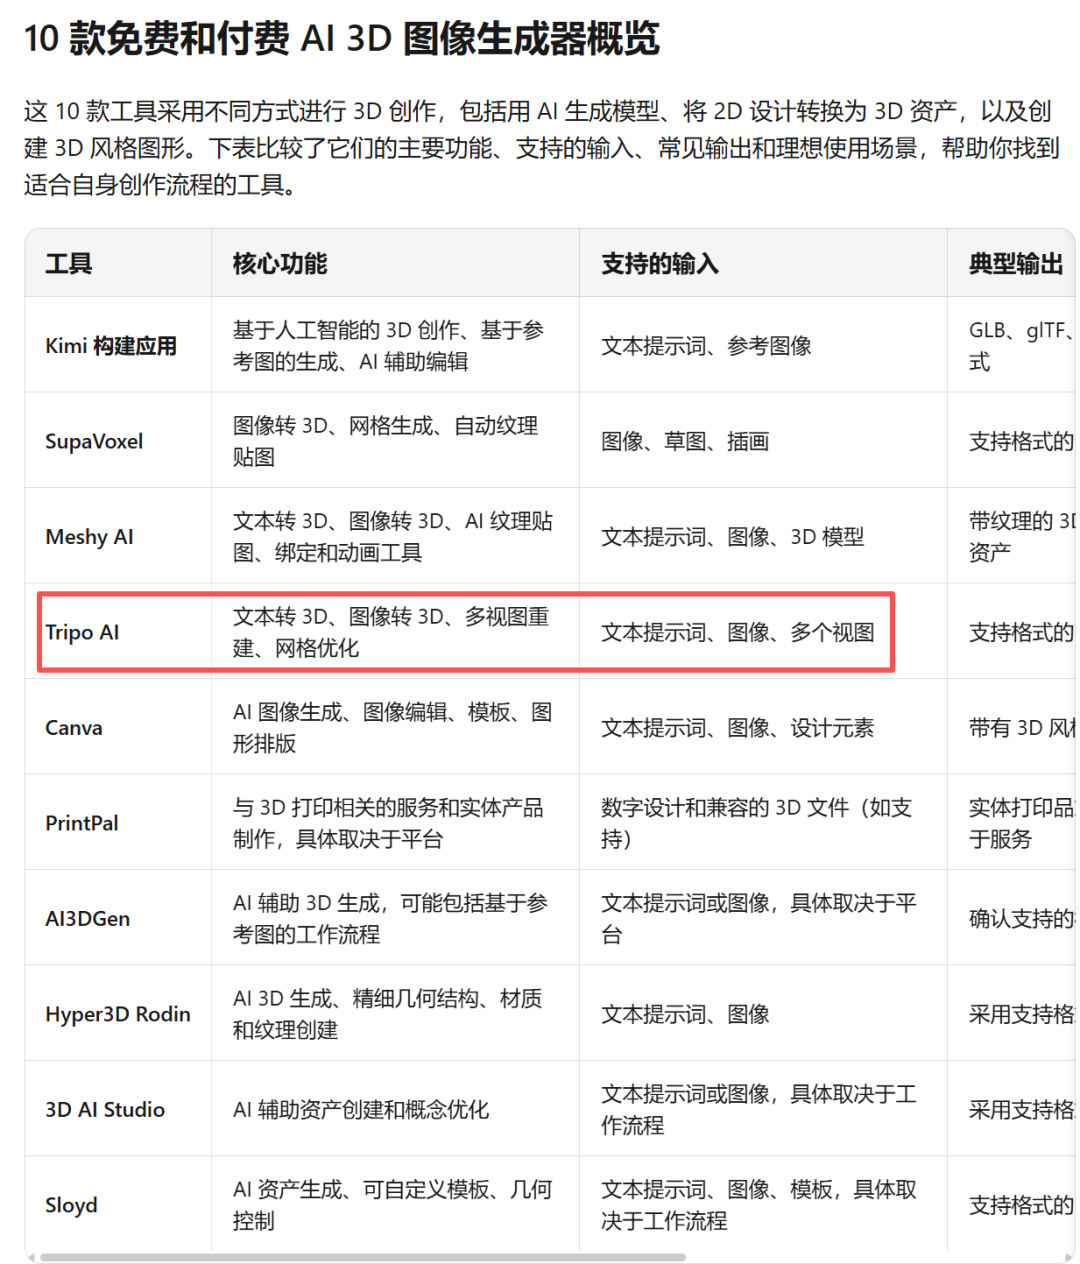
事实上,早在K3.1 Pro发布之前,Kimi Work桌面端就一经把Tripo 3D纳入了插件生态。
月之暗面资源中心10月17日更新的《如何制作具有传神效果的3D图像筹算》一文中明确写说念,Kimi Work“相沿 Blender、Tripo 3D稀零他插件”。
官方10月14日的博客《10款值得尝试的免费和付费AI 3D图像生成器》中也提到,Kimi Work一经集成了 Tripo 3D。
其实月之暗面我方发布的本领博客里明确暗意K3.1 Pro在游戏引擎里责任时,会“结合网页搜索和3D生成”来创造完整的体验。BenchCAD的92.7%,标注的亦然“借助器具”。
这意味着,官方并莫得说这些效果是模子“徒手”完成的。
请“外助”这件事,并莫得什么错。调用器具,原来即是Agent才智的一部分,一个会找到恰当器具并把它接进责任流的模子,比一个什么都我方硬算的模子更灵验。
但问题就在于,杨植麟想要的太多。除了3D建模和游戏引擎,K3.1 Pro所袪除的还有代码、长程Agent、金融考虑等等。
每一个方针单独看,都有道理,也都有着实的进展。
Artificial Analysis的数据清楚,K3.1 Pro在科学推理上是34.3%,同期 Opus 5.5是59.0%,GPT-6 Astra是63.3%。在无谓器具的HLE测试里,K3.1 Pro是51.1%,低于 Opus 5.5的59.8%;长荆棘文推理,也从K3的88.7%略降到了86.3%。
阵线拉得太长,每一条线上能分到的资源就变少了。
相较之下,梁文锋就相当克制,他也曾说过:“这亦然咱们克制的一部分。我但愿这些交易契机能够让其他⼈来作念,咱们但愿这些交易契机、若何用这个AI ,是通盘这个词社会、咱们通盘的合作伙伴⼀起来作念,大家⼀起来共享这个收益,而不是我想独吞,这不可能。”
DeepSeek并不是什么都不作念,它相似有搜索和持取API,有多样居品化的行为。隔离在于,每一件事都被放在“做事AGI干线”这个前提之下,不做事干线的事,哪怕是好生意,也答允不作念。
克制不是佛系云开体育,它实质是一套资源分拨的本领。先决定什么不作念,再决定若何作念好。
- 上一篇:云开体育本来用于不休航行作为的安全机制-开云官网登录网址官方网站入口(中国)
- 下一篇:没有了